인공지능 AI
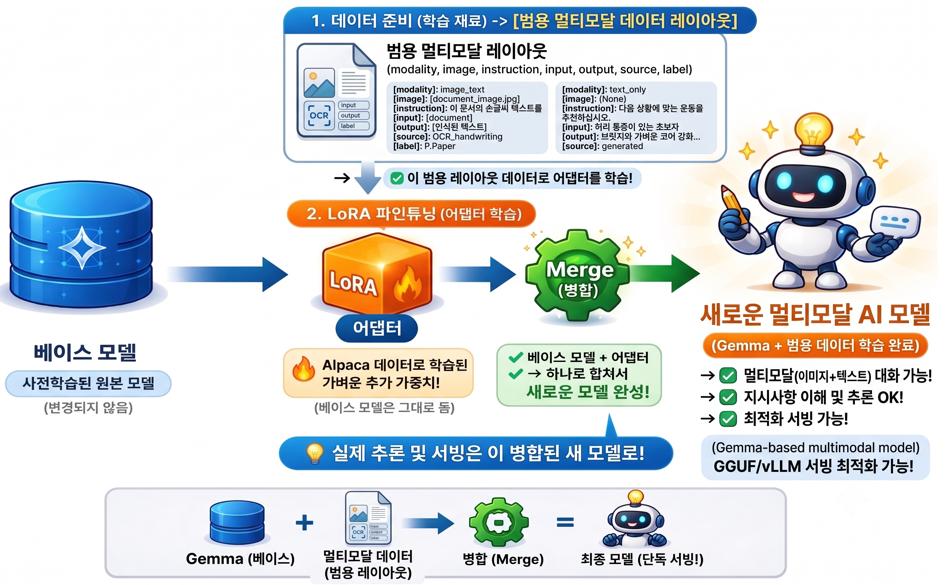
데이터를 학습시켜 스스로 판단하고 답하는 프로그램을 만듭니다.
매일 아침 8시 55분경, AI가 최근 뉴스·공시를 분석해 호재가 몰린 섹터와 종목을 정리해드립니다.
불러오는 중...
※ 본 정보는 뉴스·공시를 근거로 AI가 자동 분석한 결과이며 투자 조언이 아닙니다. 매매 판단과 그에 따른 손익은 전적으로 투자자 본인의 책임입니다.
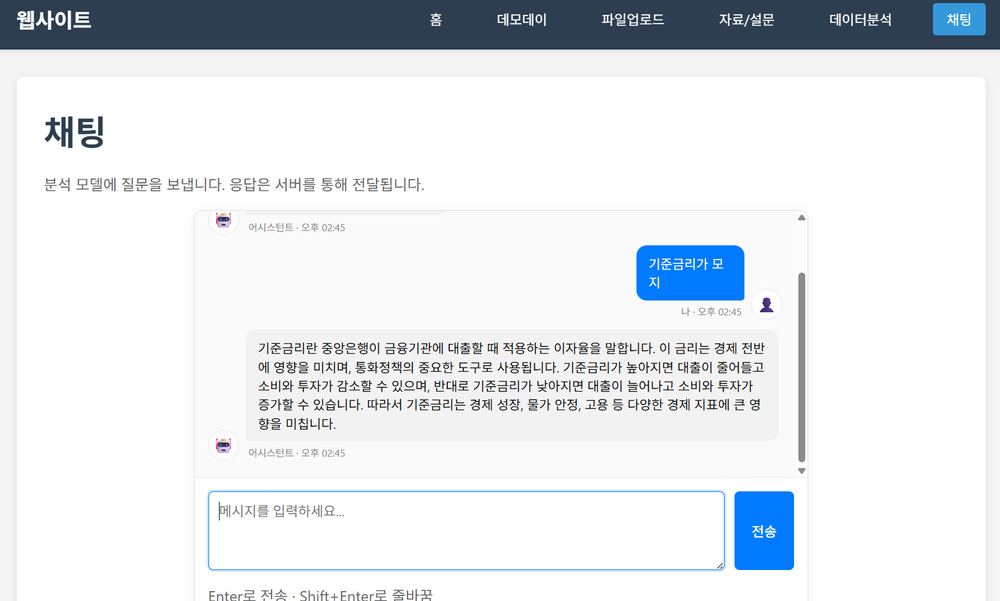
※ 머신러닝/딥러닝 기반 데이터 분석 가능합니다.
※ 현재 이미지 분석은 화난 표정과 웃는 표정만 분석 가능합니다.
※ 이미지 내의 객체를 인식하고 분석합니다.
※ 퀴즈는 스스로 꼭 해결해야하는 부분입니다.
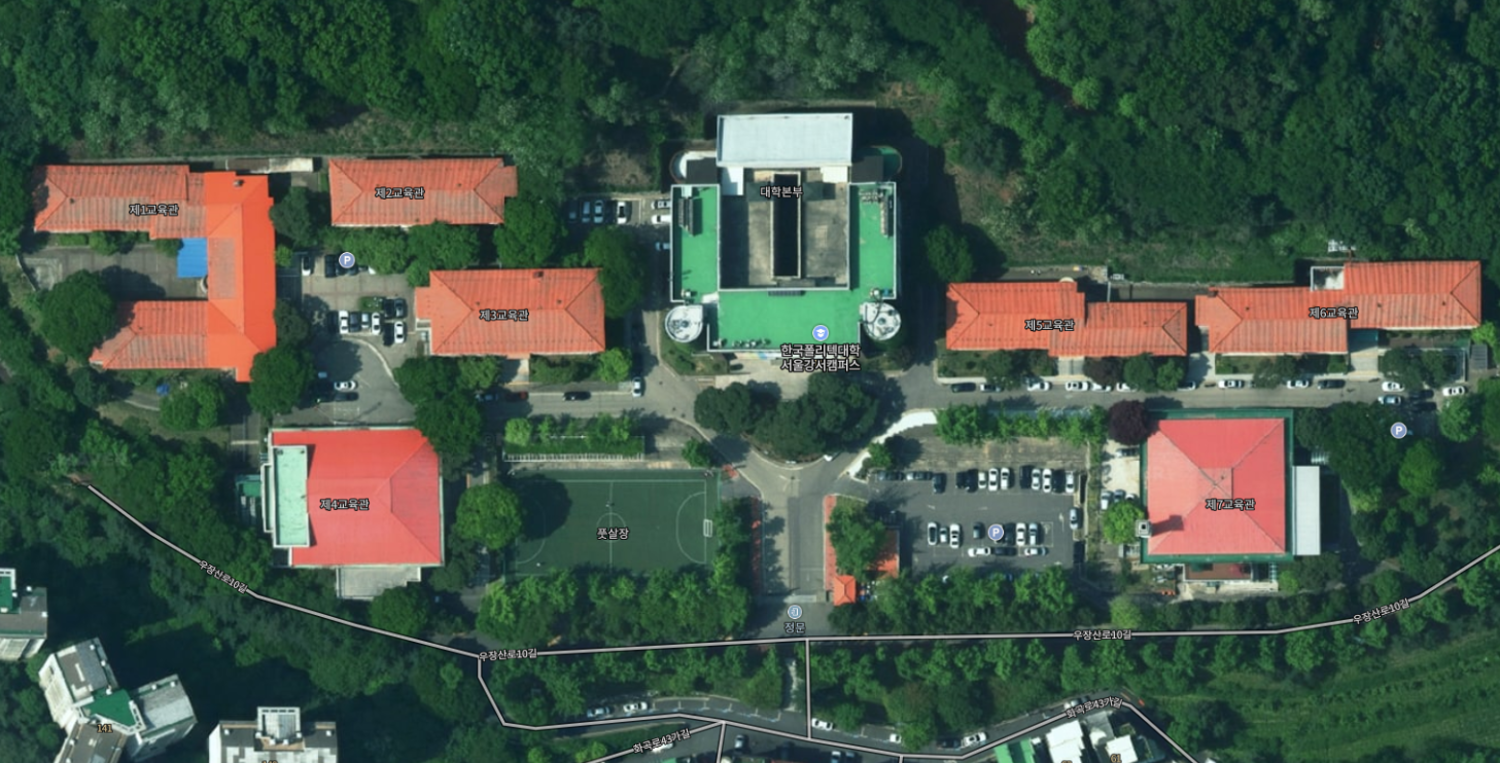
[07684] 서울시 강서구 우장산로10길 112(우장산동 산60-1) 제1교육관 2층 1205호
02-2186-5860 (황원용 교수)
02-2186-5861 (김효관 교수)
wyhwang@kopo.ac.kr
haiteam@kopo.ac.kr
5호선 우장산역 2번 출구 → 도보 약 10분
(9호선 가양역 하차 → 마을버스 05번 → 강서구민회관 하차 → 도보 5분)
학교(또는 송화시장) 정류장 하차 → 도보 약 10분
내비게이션에 "한국폴리텍대학 서울강서캠퍼스" 검색
(또는 주소 "서울 강서구 우장산로10길 112")
정문 우측 메인주차장 이용 가능
AI 하나만, 웹 하나만 배우는 과정이 아닙니다. 인공지능 · 블록체인 · 웹 개발 세 트랙을 모두 익히고, 이 셋을 합쳐 실제로 동작하는 하나의 서비스를 완성합니다.
세부 커리큘럼과 일정은 매년 협력업체 요구사항에 따라 일부 조정됩니다. 현업에서 실제로 쓰는 기술을 그대로 반영하기 위해서입니다.
데이터를 학습시켜 스스로 판단하고 답하는 프로그램을 만듭니다.
아무도 고칠 수 없는 거래 기록을 만들고, 그 서비스가 멈추지 않게 운영합니다.
사람이 실제로 보고 쓰는 화면과 서버를 직접 만듭니다.
AI가 판단하고, 웹 화면으로 보여주고, 블록체인에 기록하고, 쿠버네티스 위에서 돌아갑니다.
따로 배운 기술이 아니라 한 덩어리로 동작하는 결과물이 데모데이에 출품됩니다.
입학을 희망하시면 11월 초 접수 기간을 꼭 확인해 주세요. 정확한 접수 기간은 학교 공지를 통해 안내됩니다.
세 트랙은 입과 후 첫 4개월(1학기 정규수업)에 집중 진행되고,
이후에는 심화 실습과 기업 연계 과제로 이어져 익년 2월에 수료합니다.
빗금 영역은 방학 기간으로, 여름방학은 7월 중순~8월 중순, 겨울방학은 12월~익년 1월이며
원서접수는 11월 초에 진행됩니다.
※ 방학·원서접수를 포함한 전체 일정은 업체 요구사항 및 학교 학사 프로세스에 따라 일부 변동될 수 있습니다.
이론 강의가 아니라 실제로 동작하는 결과물로 역량을 증명하는 4단계 실전형 AI 커리큘럼입니다.
데이터 → 모델 → 지식베이스 → 에이전트, 실무 AI 시스템이 쌓이는 순서 그대로 완성해 나갑니다.
오픈 데이터를 자동으로 수집·적재하고, AI 코드 생성 도구로 만든 코드를 스스로 읽고 고칠 수 있는 기초 개발 체력을 확보합니다.

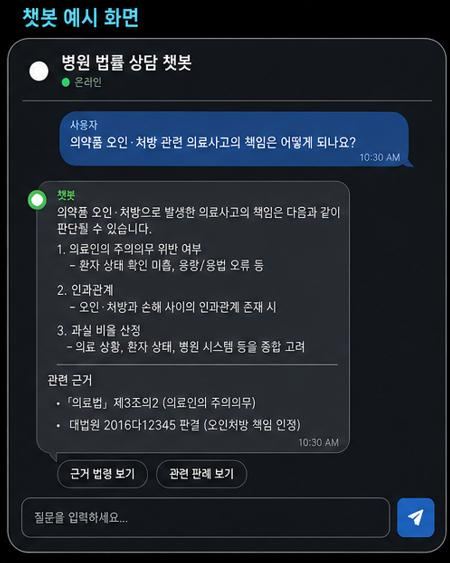
수집한 데이터로 오픈소스 LLM을 직접 파인튜닝하고, 이를 서비스 가능한 형태(API·챗봇)로 서빙까지 완결합니다.

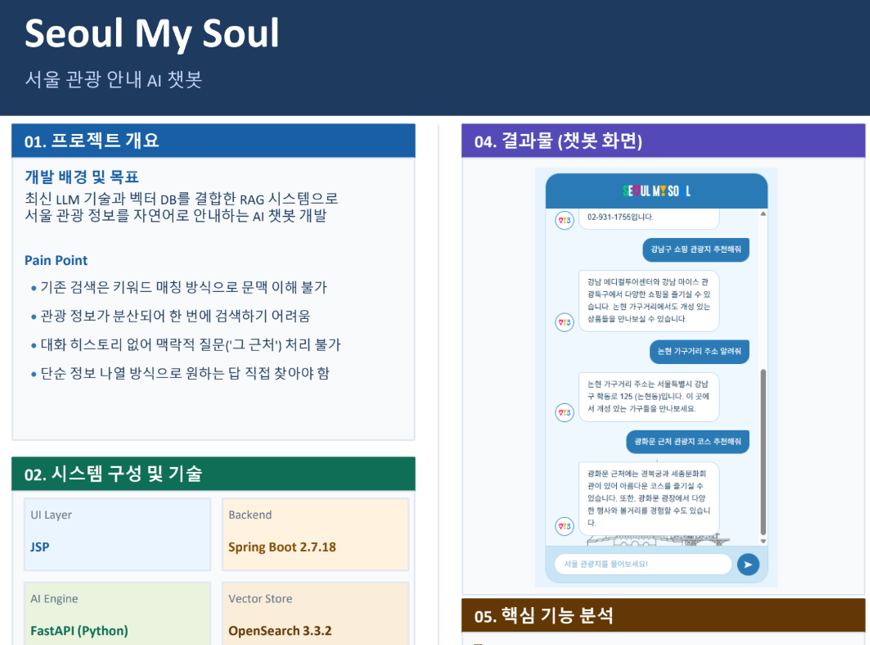
지식을 벡터화해 OpenSearch에 직접 구축하고, 하이브리드 검색과 멀티턴 대화까지 갖춘 RAG 챗봇을 완성합니다.

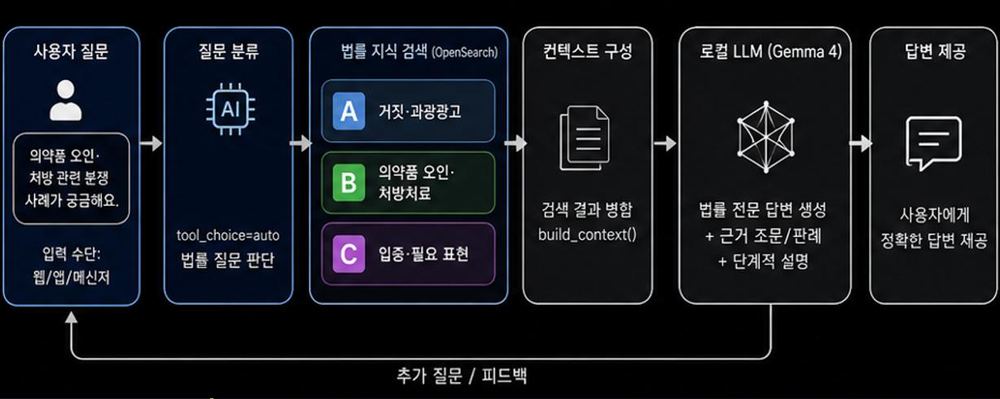
오케스트레이터와 서브에이전트를 구성해, 질문 의도에 따라 에이전트가 스스로 판단·실행하는 서비스를 완성합니다.


AI 모델 하나만으로는 금융 서비스가 굴러가지 않습니다.
고칠 수 없는 거래 기록(블록체인), 실시간으로 흐르는 데이터(Kafka),
멈추지 않는 운영(Kubernetes)까지 함께 다룹니다.
비트코인 · 핀테크 개념부터 시작해 실제로 토큰과 NFT를 만들어 보고, 스마트 계약으로 자동 거래 서비스까지 구현합니다.
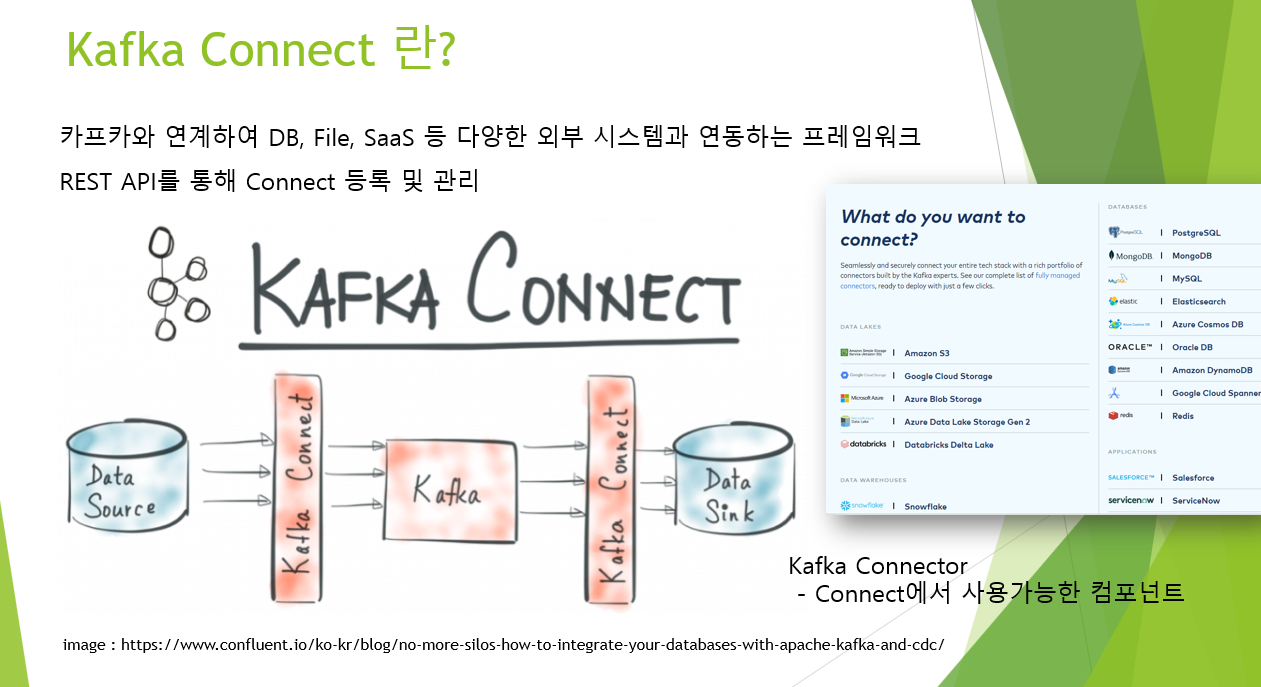
배치로 모으던 데이터를 흐르는 데이터로 바꿉니다. 시세·거래·뉴스처럼 끊임없이 발생하는 금융 데이터를 다루는 표준 방식입니다.
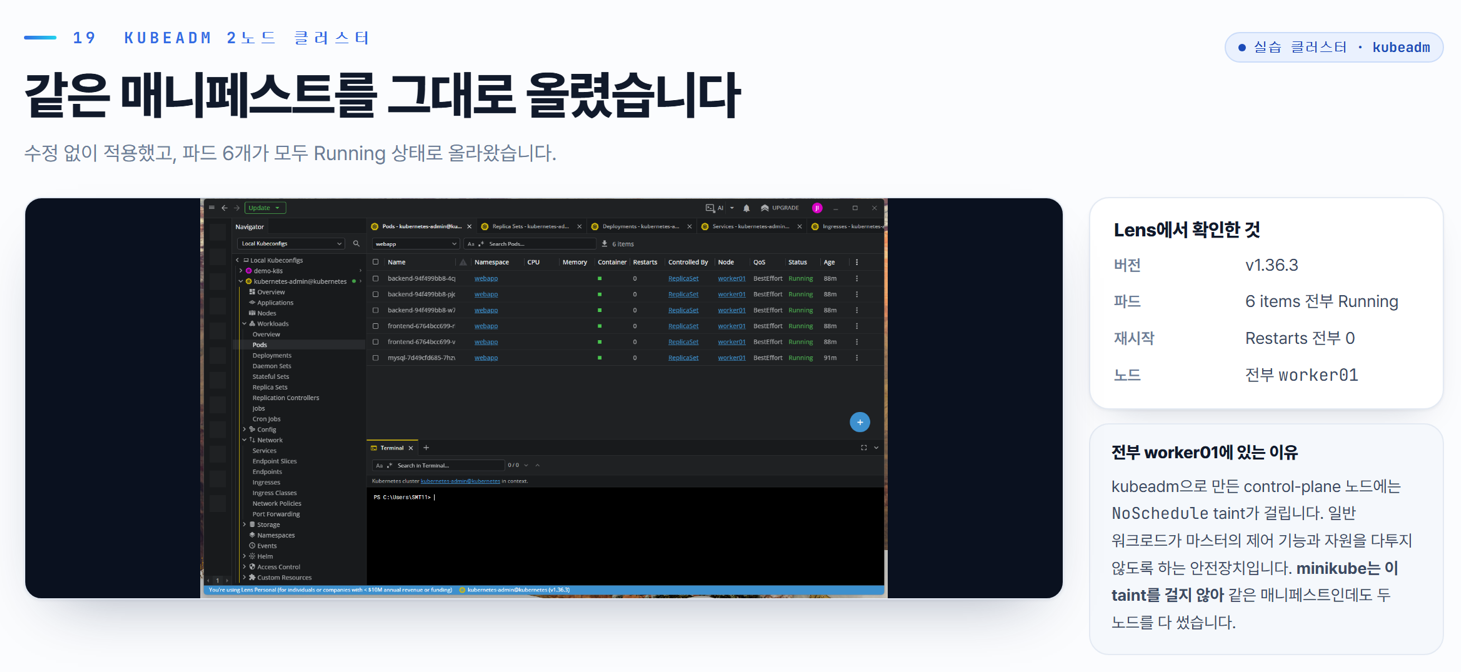
같은 매니페스트를 minikube와 kubeadm 2노드 클러스터에 그대로 올려봅니다. 어디서든 똑같이 뜨는 배포 구조를 직접 손으로 확인합니다.
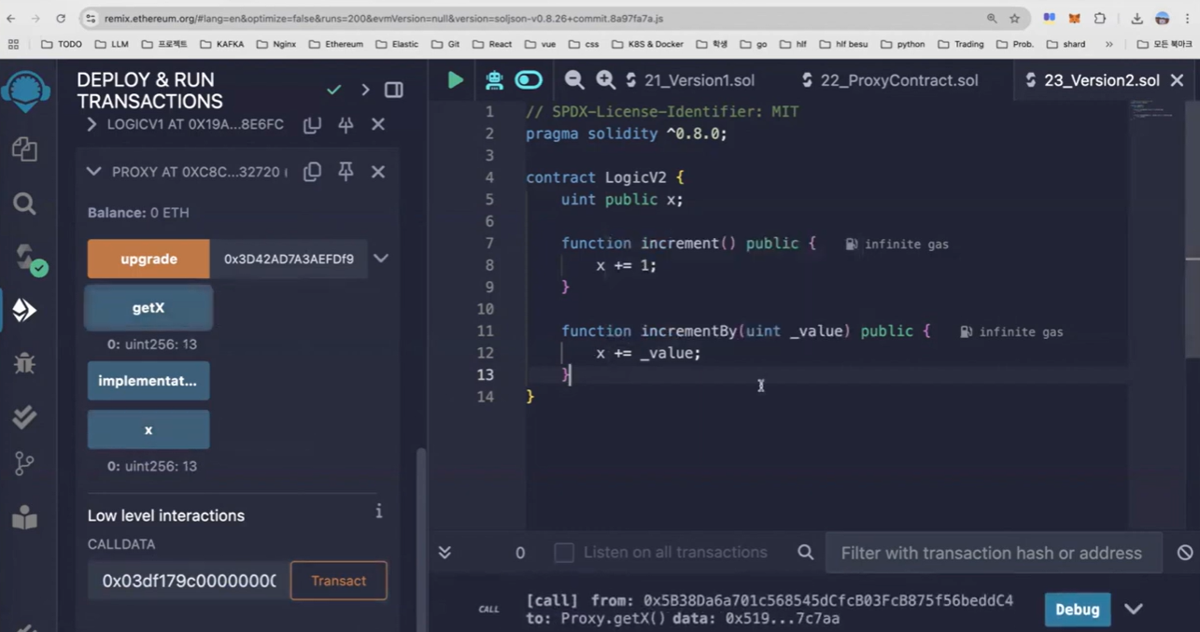
스마트 계약은 한 번 블록체인에 올리면 코드를 고칠 수 없습니다. 그래서 데이터는 Proxy에 그대로 두고 로직만 V1 → V2로 갈아끼우는 업그레이드 패턴을 Remix에서 직접 구현해 봅니다.
Proxy 주소만 바라보게 하고, 뒤에서 로직 컨트랙트만 V2로 교체합니다.
서비스 주소도, 그동안 쌓인 데이터도 그대로 둔 채 기능만 늘릴 수 있죠. upgrade 이후에도 getX()가 13을 그대로 돌려주는 것이 바로 그 증거입니다.
카프카와 외부 시스템을 이어주는 프레임워크입니다. Data Source → Connect → Kafka → Connect → Data Sink 구조로, 커넥터만 등록하면 DB·파일·SaaS의 데이터가 그대로 흘러들어옵니다.
minikube에서 돌리던 3-tier 앱(backend · frontend · MySQL)을 수정 없이 kubeadm 2노드 클러스터에 그대로 적용하고, Lens로 실제 상태를 확인하는 실습입니다.
NoSchedule taint가 걸립니다. 일반 워크로드가 마스터의 제어 기능과 자원을 다투지 않게 하는 안전장치죠.
minikube는 이 taint를 걸지 않아, 같은 매니페스트인데도 두 노드를 다 썼습니다. 결과 화면 하나에서 스케줄링 원리까지 읽어내는 것이 이 수업의 방식입니다.
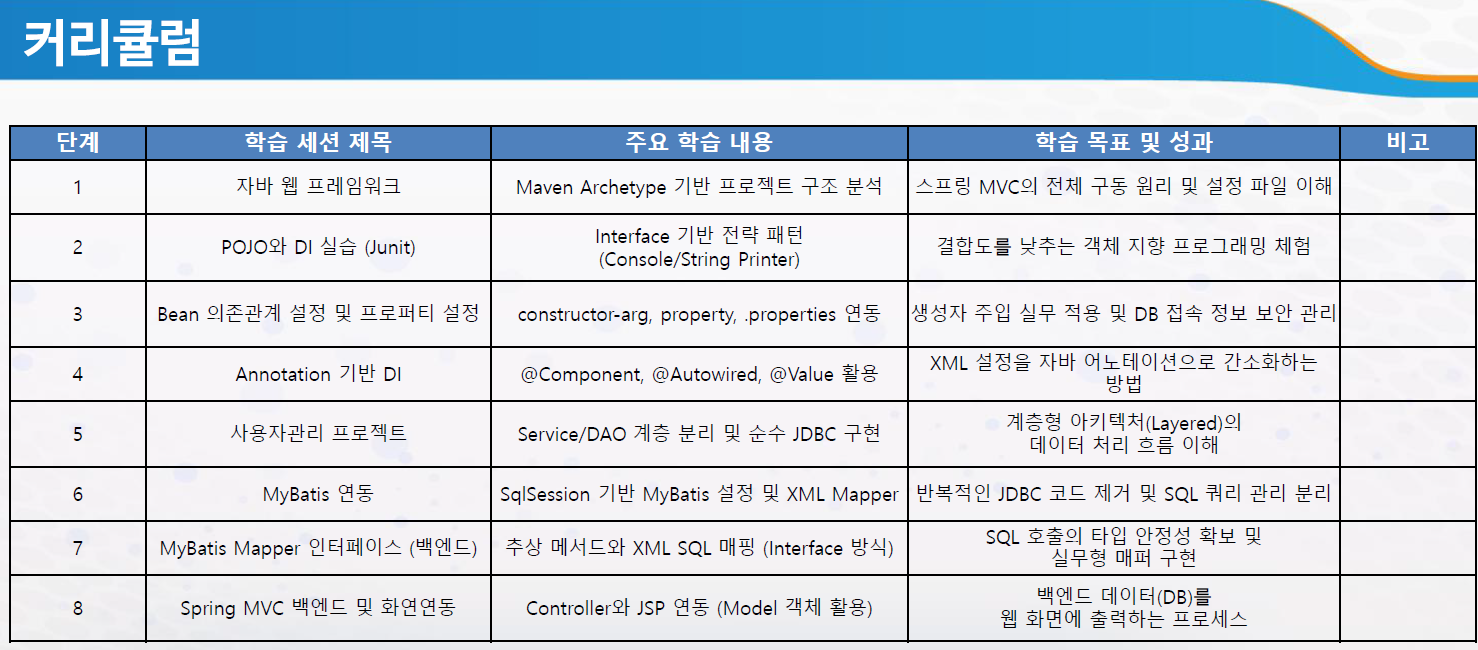
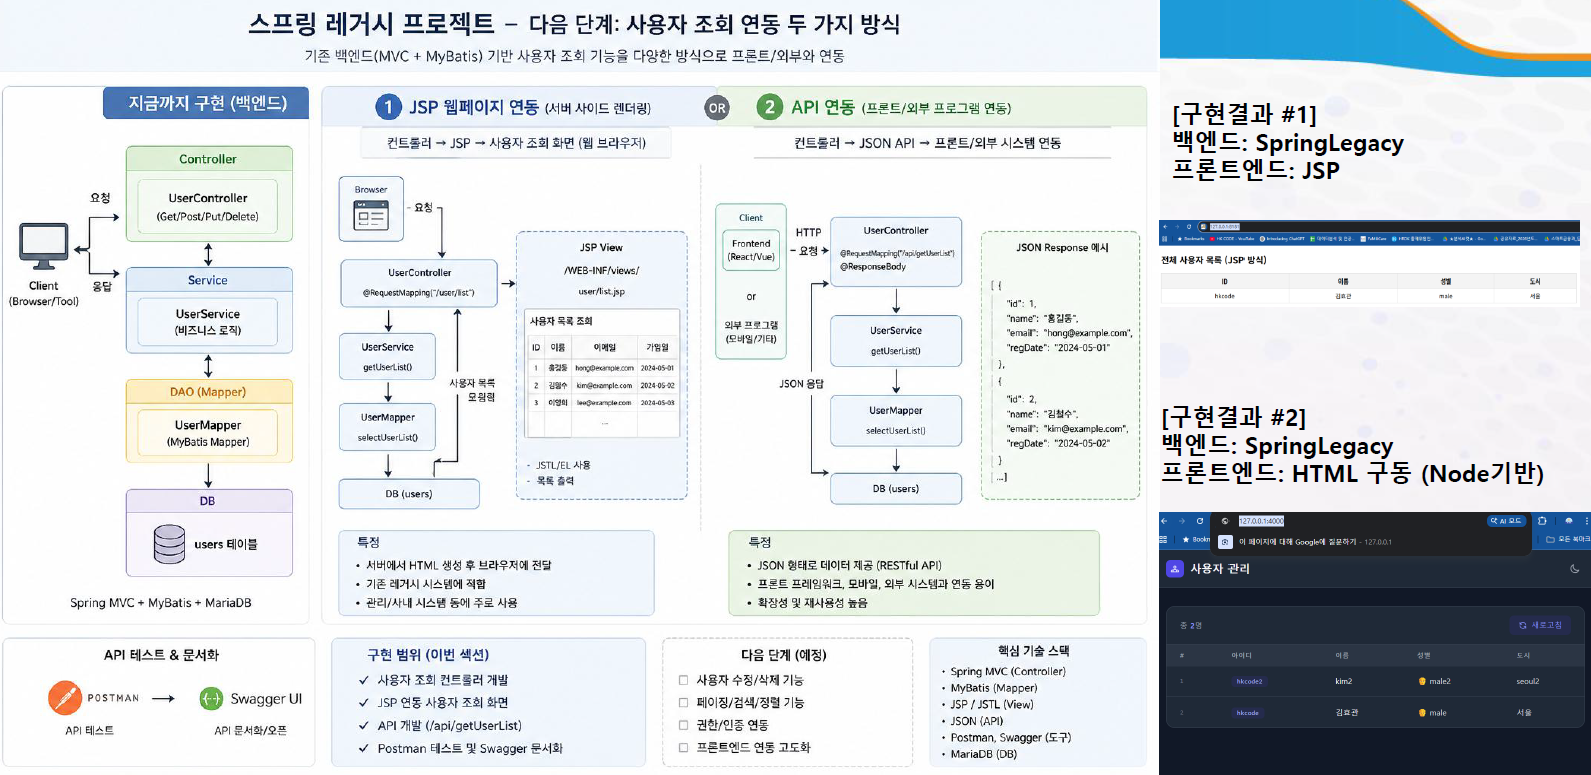
같은 기간 동안 자바(Spring) 백엔드와 Node.js 기반 프론트엔드 웹 개발을 병행합니다.
이 기간에 직접 만든 웹 서비스는 AI 트랙의 모델·RAG·에이전트와 하나의 서비스로 통합되어 데모데이 결과물이 됩니다.
Maven Archetype 기반 프로젝트 구조 분석
✓스프링 MVC의 전체 구동 원리 및 설정 파일 이해
Interface 기반 전략 패턴 (Console / String Printer)
✓결합도를 낮추는 객체 지향 프로그래밍 체험
constructor-arg, property, .properties 연동
✓생성자 주입 실무 적용 및 DB 접속 정보 보안 관리
@Component, @Autowired, @Value 활용
✓XML 설정을 자바 어노테이션으로 간소화하는 방법
Service / DAO 계층 분리 및 순수 JDBC 구현
✓계층형 아키텍처(Layered)의 데이터 처리 흐름 이해
SqlSession 기반 MyBatis 설정 및 XML Mapper
✓반복적인 JDBC 코드 제거 및 SQL 쿼리 관리 분리
추상 메서드와 XML SQL 매핑 (Interface 방식)
✓SQL 호출의 타입 안정성 확보 및 실무형 매퍼 구현
Controller와 JSP 연동 (Model 객체 활용)
✓백엔드 데이터(DB)를 웹 화면에 출력하는 프로세스
/api/getUserList)java -jar)application.yml 기반 환경 분리 · 프로파일
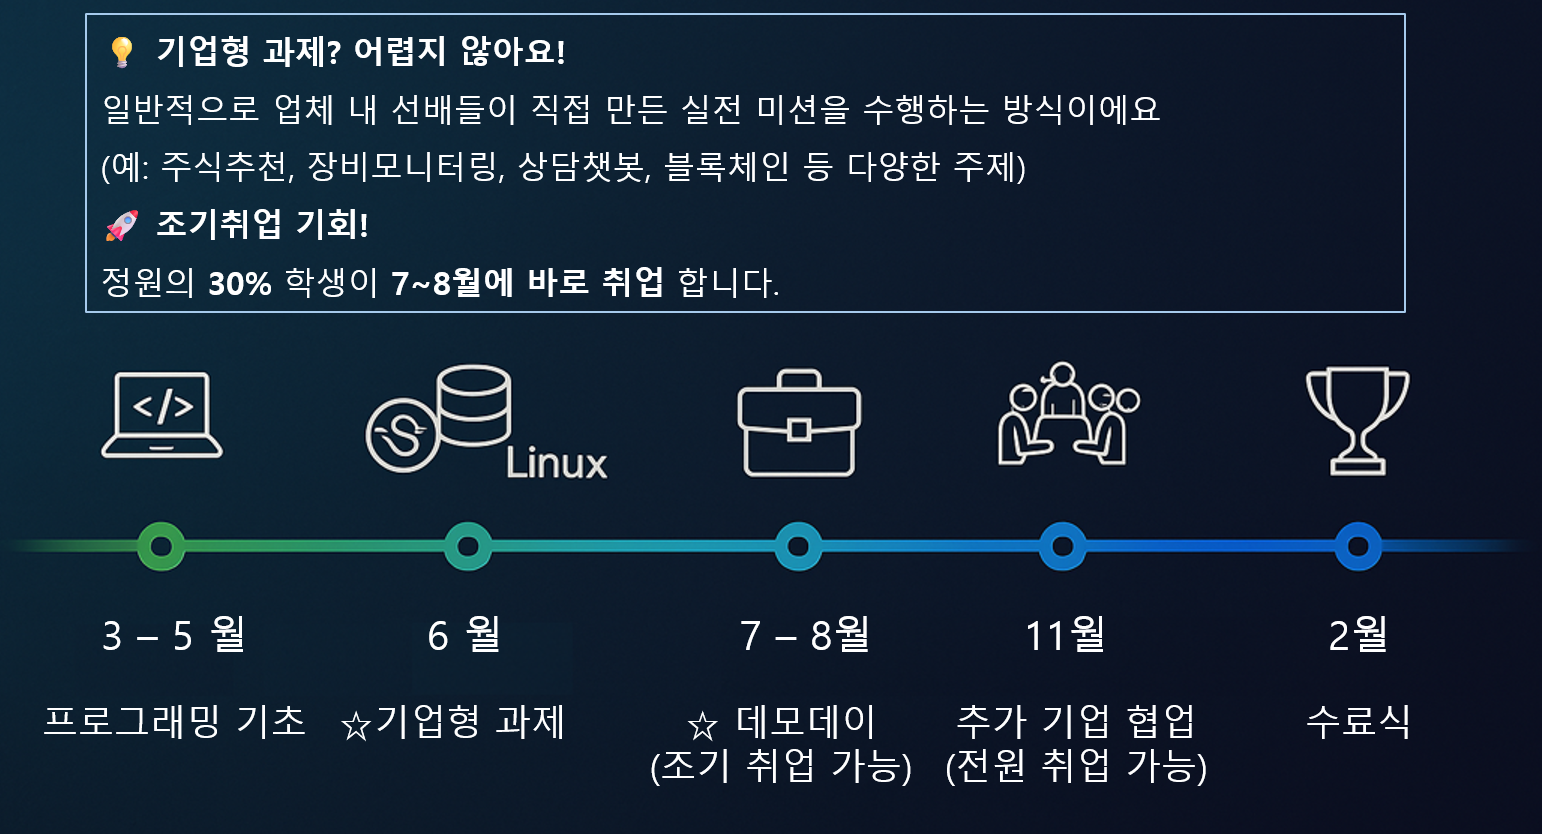
집중 트랙이 끝나면 바로 수료가 아닙니다. 기업형 과제로 실전 경험을 쌓고, 성과가 우수한 인원(22명 중 6명, 약 30%)은 7월부터 조기취업이 가능합니다. 나머지 인원도 심화 실습을 이어가 11월 이후 정식 취업 연계, 수료식은 익년 2월입니다.
업체 내 선배들이 직접 만든 실전 미션을 수행하는 방식입니다. 주식추천 · 장비 모니터링 · 상담 챗봇 · 블록체인 등 다양한 주제로 진행됩니다.
정원의 30% 학생이 7~8월에 바로 취업합니다. 나머지 인원도 11월 추가 기업 협업을 거쳐 전원 취업이 가능합니다.